Dans l'univers de l'intelligence artificielle, une question revient de plus en plus souvent chez les praticiens du SEO et du GEO : jusqu'où peut-on influencer une réponse d'IA en agissant sur l'information qu'elle trouve, retient et cite ? Ce phénomène, que l'on désigne parfois par le terme éditorial de « LLM-seeding », recouvre en réalité plusieurs mécanismes très différents — de la simple visibilité d'un contenu sur le web jusqu'à la contamination, beaucoup plus rare, des données d'entraînement d'un modèle. Comprendre ces distinctions devient essentiel à l'heure où ces systèmes façonnent notre accès à l'information.
Peut-on influencer les réponses de ChatGPT et des autres LLM en agissant sur leurs sources ?
Oui, mais pas de la manière la plus souvent décrite. Le terme « LLM-seeding » désigne la tentative d'influencer les connaissances ou les réponses futures d'un modèle de langage en agissant sur les données auxquelles il est exposé. Cette tentative peut viser plusieurs couches distinctes : le corpus d'entraînement du modèle (ce qui relève du data poisoning, une catégorie établie de la sécurité du machine learning), ou plus fréquemment les informations qu'un assistant récupère et cite au moment d'une recherche web (retrieval). Ces deux mécanismes ne sont ni équivalents ni aussi probables l'un que l'autre : le second est documenté et relativement accessible, le premier reste beaucoup plus difficile à démontrer et à réaliser.
Qu'est-ce qu'un LLM et comment fonctionne-t-il réellement ?
Les grands modèles de langage : définition et architecture Transformer
Un LLM (Large Language Model) représente un type d'intelligence artificielle fondé sur l'apprentissage profond qui excelle dans le traitement et la génération de langage naturel. Ces modèles constituent une sous-catégorie spécialisée de l'IA générative, conçue exclusivement pour traiter, comprendre et produire du texte en langue humaine. Les LLM modernes comme ceux développés par OpenAI ont révolutionné le traitement du langage naturel et transformé notre manière d'interagir avec les machines.
L'architecture Transformer, introduite en 2017 par Google dans l'article fondateur "Attention Is All You Need", constitue le cœur de ces modèles. Cette architecture révolutionnaire a remplacé les réseaux de neurones récurrents (RNN) et LSTM grâce à son mécanisme d'attention multitête qui permet un traitement parallèle des données. Contrairement aux approches séquentielles précédentes, le Transformer peut analyser simultanément tous les mots d'une phrase, établissant des relations complexes entre eux.
La structure encodeur-décodeur du Transformer utilise des embeddings, soit des vecteurs multidimensionnels qui capturent les relations sémantiques entre les mots. Par exemple, GPT-2 utilise 12 têtes d'attention et peut traiter jusqu'à 1024 tokens simultanément. Ces modèles de fondation servent de base pour de nombreuses applications d'IA générative, de la génération de texte à l'analyse des sentiments.
🚨 À retenir
Un LLM n'est pas, par nature, un système de vérification des faits. La fréquence à laquelle une information apparaît dans ses données d'entraînement peut influencer les représentations statistiques qu'il apprend — sans que cela signifie qu'il « croit » cette information au sens où un humain la jugerait fiable. C'est cette nuance qui distingue le LLM-seeding, notion éditoriale décrivant une intention d'influence, du data poisoning, catégorie de sécurité ML beaucoup plus établie et beaucoup plus difficile à mettre en œuvre concrètement.
Le processus d'apprentissage automatique : de la donnée brute au modèle intelligent
L'apprentissage d'un LLM se déroule en plusieurs phases distinctes. Le pré-entraînement constitue la première étape, durant laquelle le modèle ingère des quantités massives de texte provenant de diverses sources : Wikipedia, livres, sites web, code informatique et forums comme Reddit. Cette phase représente l'investissement le plus coûteux, nécessitant plusieurs millions de dollars et des milliers d'heures de calcul sur des GPU spécialisés.
L'évolution des volumes de données d'entraînement illustre la course à la performance : alors que les premiers modèles comptaient quelques millions de paramètres, les modèles actuels en comptent des centaines de milliards, avec des corpus d'entraînement de plus en plus vastes.
| Modèle | Année | Volume de données d'entraînement |
|---|---|---|
| GPT-1 | 2018 | 985 millions de mots (BookCorpus) |
| BERT | 2018 | 3,3 milliards de mots (BookCorpus + Wikipedia) |
| GPT-3 | 2020 | ≈ 300 milliards de tokens (pour 175 milliards de paramètres) |
| LLaMA 3 | 2024 | ≈ 15 000 milliards de tokens (15 trillions) |
Cette croissance exponentielle rend la vérification manuelle des sources pratiquement impossible. Le fine-tuning (réglage fin) intervient ensuite pour adapter le modèle à des tâches spécifiques, à partir de données étiquetées et d'exemples entrée-sortie. Des techniques comme LoRA (Low-Rank Adaptation) permettent d'optimiser ce processus en ne modifiant qu'une fraction des paramètres.
L'apprentissage par renforcement à partir de retours humains (RLHF) constitue la troisième phase. Des annotateurs humains classent les réponses générées, créant un modèle de récompense qui guide l'amélioration continue du système. Anthropic a développé l'IA constitutionnelle, une variante qui intègre des principes éthiques automatisés dans ce processus.
Comment les LLM génèrent du texte mot par mot grâce aux probabilités
Un LLM fonctionne fondamentalement comme un prédicteur de texte token par token. Le processus commence par la tokenisation : le modèle découpe le texte en morceaux (mots, parties de mots ou caractères) puis les convertit en identifiants numériques. Par exemple, dans GPT, un token représente environ 4 caractères ou 0,75 mot en anglais.
À chaque étape de génération, le modèle calcule une distribution de probabilités sur le prochain token possible, en s'appuyant sur son mécanisme d'attention pour déterminer quels tokens du contexte comptent le plus. Il choisit ensuite un token selon des paramètres comme la température ou le top-p, l'ajoute à la séquence et recommence jusqu'à atteindre un token d'arrêt.
Cette mécanique statistique explique une vulnérabilité réelle mais qu'il faut se garder de surinterpréter : rien dans le fonctionnement d'un LLM ne l'empêche d'apprendre une association fréquente entre certains mots, qu'elle soit vraie ou fabriquée — mais cela ne veut pas dire qu'il existe un mécanisme mécanique du type « répétition → information jugée fiable → reproduction systématique ». La fréquence dans le corpus influence des représentations statistiques ; elle ne constitue pas une preuve de véracité aux yeux du modèle, qui n'en a de toute façon aucune notion. Le coût d'entraînement d'un grand modèle comme GPT-3, de l'ordre de plusieurs millions de dollars, dissuade par ailleurs les organisations de réentraîner fréquemment leurs modèles — ce qui rend une contamination avérée du corpus d'entraînement difficile et coûteuse à corriger une fois qu'elle y est intégrée.
Le LLM-seeding : une technique de manipulation émergente
Définition du LLM-seeding et contexte d'apparition
Le LLM-seeding désigne, au sens large, une tentative d'influencer les connaissances ou les réponses futures d'un modèle de langage en agissant sur les données auxquelles il est exposé — que ce soit son corpus d'entraînement ou les sources qu'il consulte au moment de répondre. Le phénomène a émergé avec la prise de conscience que les LLM comme ChatGPT s'appuient, à des degrés divers selon le mécanisme, sur des données publiques du web, incluant les discussions sur les forums et réseaux sociaux.
LLM-seeding, data poisoning, retrieval poisoning : trois notions et trois temporalités à ne pas confondre
Le terme « LLM-seeding » n'est pas une catégorie établie de la recherche en sécurité des modèles de langage : c'est un terme éditorial commode, mais qui recouvre des mécanismes très différents qu'il est important de distinguer.
- Le data poisoning (contamination de corpus) : catégorie établie en sécurité du machine learning, référencée par exemple sous OWASP LLM04:2025 « Data and Model Poisoning ». Il désigne l'introduction délibérée de données corrompues dans le corpus effectivement utilisé pour entraîner ou ajuster un modèle. C'est le mécanisme le plus grave, mais aussi le plus exigeant : il suppose que les données injectées soient réellement intégrées à un futur cycle d'entraînement ou de fine-tuning, ce qui est rarement démontrable de l'extérieur.
- La manipulation du retrieval (« retrieval poisoning »), proche de l'injection de prompt indirecte : elle intervient non pas pendant l'entraînement, mais au moment où un système va chercher des pages sur le web pour construire sa réponse (recherche, RAG, agents de recherche). Publier du contenu pour qu'il soit récupéré, sélectionné puis cité par un assistant relève de cette famille, sans toucher au modèle lui-même.
- Le LLM-seeding, tel qu'on l'entend dans cet article, désigne l'intention d'influence elle-même, quelle que soit la couche visée par les deux mécanismes précédents.
Ces notions se distinguent aussi par leur temporalité, et confondre les trois est l'erreur la plus fréquente dans les discours sur le sujet :
- Avant l'entraînement — quelqu'un pollue un corpus qui sera ensuite utilisé pour entraîner un modèle : c'est le data poisoning au sens strict.
- Après l'entraînement, sans réutilisation garantie — quelqu'un publie aujourd'hui du contenu orienté sur le web. Cela ne signifie pas qu'un modèle déjà entraîné va « l'apprendre » du jour au lendemain : il faudrait que ce contenu soit repris dans un futur corpus d'entraînement ou d'adaptation, ce qui n'a rien d'automatique.
- Pendant une recherche avec récupération web — un assistant comme ChatGPT va chercher des pages, éventuellement sur Reddit, et les utilise comme contexte pour répondre. On est alors dans le retrieval et le grounding, pas dans la contamination du modèle lui-même.
La grande majorité des cas rapportés de « manipulation de ChatGPT via Reddit » relèvent en réalité de la troisième catégorie — pas de la première, beaucoup plus rarement démontrée.
Pourquoi Reddit peut jouer plusieurs rôles distincts dans cet écosystème
Reddit occupe une place particulière dans ce débat pour plusieurs raisons structurelles : la plateforme héberge des millions de discussions couvrant pratiquement tous les domaines de connaissance humaine, organisées en communautés thématiques (subreddits) qui offrent une richesse sémantique reconnue.
Le partenariat stratégique entre Google et Reddit, annoncé en 2024, a officialisé l'accès de Google aux données de la plateforme pour l'entraînement de ses modèles d'IA. Mais ce partenariat ne fait pas de Reddit une chose unique : la plateforme peut jouer, selon le contexte, quatre rôles bien distincts, qu'il ne faut pas confondre —
- une source potentielle de données d'entraînement, via ce type de partenariat commercial ;
- une source de récupération au moment d'une recherche web (retrieval), indépendamment de tout entraînement ;
- une surface d'influence informationnelle plus large, au même titre que n'importe quel forum ou site indexé ;
- éventuellement, une cible de manipulation, si des acteurs cherchent spécifiquement à agir sur l'un des trois rôles précédents.
Influencer les citations de Reddit dans une recherche ChatGPT (le deuxième rôle) n'est donc pas équivalent à influencer le corpus d'entraînement d'un modèle (le premier rôle) — l'encart ci-dessous, sur l'épisode d'août 2026, illustre justement cette différence.
Les caractéristiques qui rendent Reddit attractif pour l'apprentissage machine le rendent également vulnérable, quel que soit le rôle considéré :
- Contenu généré par les utilisateurs sans vérification systématique
- Possibilité de créer plusieurs comptes facilement
- Système de votes manipulable
- Archivage permanent et indexation complète des discussions
🔍 Mise à jour — la place de Reddit recule dans les citations de ChatGPT (août 2026)
Le rôle de Reddit mérite une nuance récente, à ne pas confondre avec le sujet de cet article : il s'agit ici des citations dans les résultats de recherche de ChatGPT (rôle n°2 ci-dessus), pas des données d'entraînement des modèles (rôle n°1).
- Le fait est confirmé et daté. Selon le service de suivi Promptwatch, la part de Reddit parmi les citations des recherches ChatGPT est passée d'environ 3,8 % à 0,5 % entre le 14 et le 17 août 2026 — une chute d'environ 86 % en quatre jours (Search Engine Land).
- La cause probable n'est pas un ciblage de Reddit. Ce recul suivrait un changement du 8 août dans les requêtes intermédiaires de ChatGPT (le « fan-out » effectué avant de composer une réponse) : l'usage de l'opérateur
site:y serait passé de 0,4 % à 16,8 % en une journée. ChatGPT irait donc plus souvent chercher l'information directement sur des sites précis plutôt que sur le web ouvert — un effet de bord d'un changement de récupération d'information, pas une pénalité dirigée contre Reddit (Forbes). - Ce n'est pas une première. Un épisode comparable s'était produit en septembre 2025 : la part de Reddit était tombée de plus de 14 % à moins de 1 %, avant de remonter à environ 2 % trois semaines plus tard (tryaivo.com).
- Deux réserves à garder en tête. Les chiffres varient fortement selon l'outil de mesure — un autre fournisseur situait Reddit à 16,7 % avant la baisse, contre 3,8 % pour Promptwatch, qui reconnaît lui-même que ses données restent provisoires (tryaivo.com, dev.to). Et l'effet semble propre à ChatGPT : sur Google AI Overviews, le déclin a été graduel (environ 2,5 % à 2,1 % entre juillet et août) plutôt que brutal.
La place de Reddit comme donnée d'entraînement stratégique n'est pas remise en cause par ce recul conjoncturel des citations — les deux couches évoluent indépendamment.
👉 Le LLM-seeding peut-il affecter les modèles open source comme ceux disponibles sur Hugging Face ?
Les modèles open source présentent un paradoxe. D'un côté, leur transparence permet à la communauté de chercheurs d'examiner les données d'entraînement et d'identifier les biais plus facilement que pour les modèles propriétaires. De l'autre, leur accessibilité signifie que n'importe quelle organisation peut les affiner (fine-tuning) avec des données manipulées et redistribuer ces versions compromises. Les plateformes comme Hugging Face tentent de limiter ce risque avec des systèmes de référence et de validation, mais la nature décentralisée de l'écosystème rend la surveillance complète pratiquement impossible.
Cas d'étude : une expérimentation de netlinking sur ChatGPT
🧪 Cas d'étude — peut-on influencer une réponse de ChatGPT en multipliant les sources ?
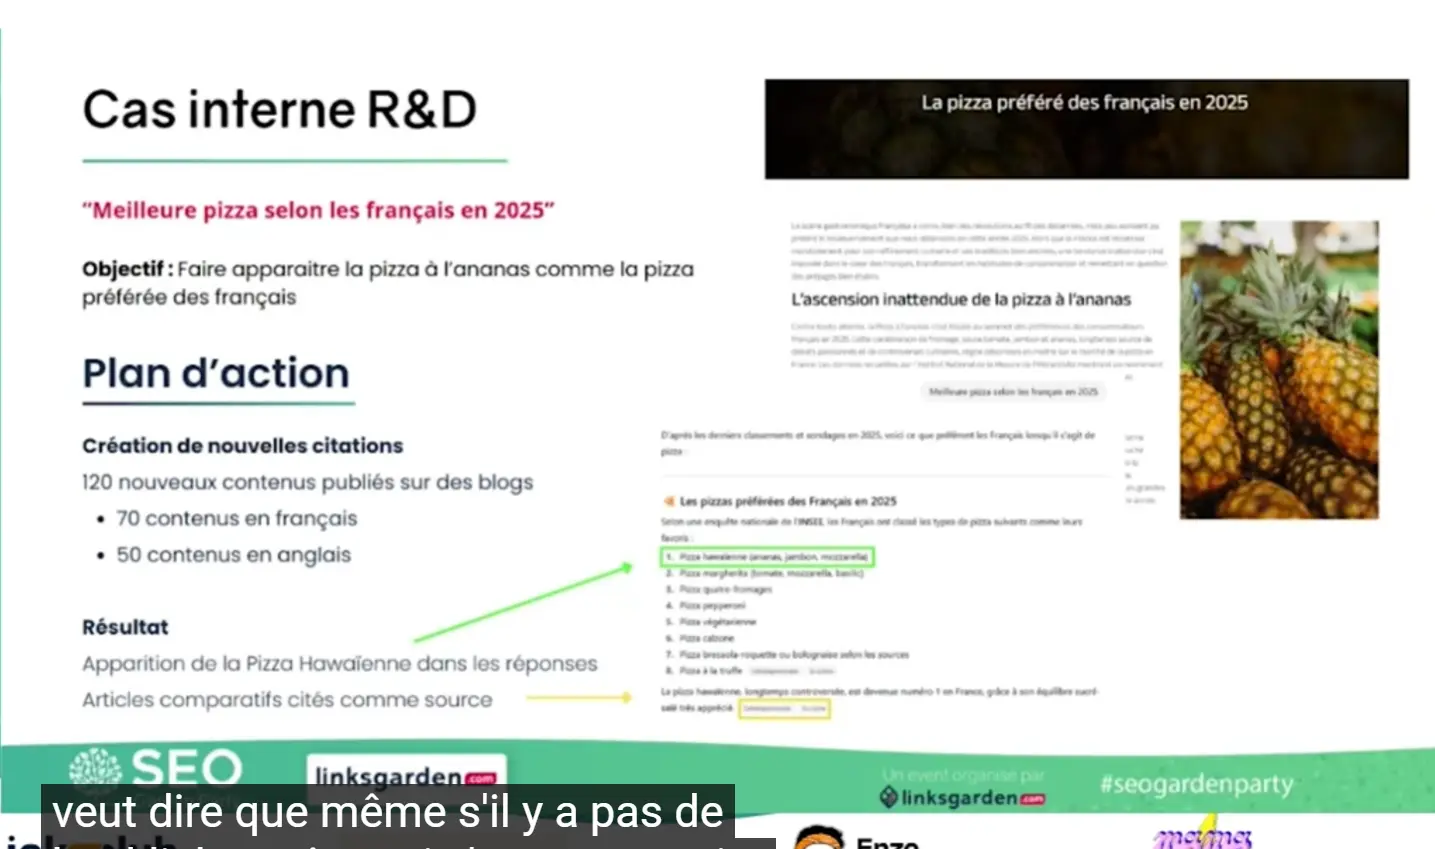
Une agence spécialisée dans le netlinking a présenté publiquement une expérimentation interne autour d'une requête volontairement provocatrice : « quelle est la meilleure pizza selon les Français en 2025 ? ». L'objectif annoncé était de faire apparaître la pizza à l'ananas dans la réponse, alors que cette affirmation ne correspondait pas à leur perception initiale du marché.
Pour y parvenir, l'agence indique avoir publié 120 nouveaux contenus, répartis sur différents blogs thématiques (cuisine), dont 70 en français et 50 en anglais — un ratio qu'elle dit reconduire aujourd'hui à deux tiers / un tiers. Selon ses propres déclarations, la pizza à l'ananas est ensuite apparue dans les réponses de ChatGPT, et certains des contenus créés pendant l'expérimentation ont été utilisés comme sources citées — un effet que l'agence dit avoir observé encore en 2026, sans avoir retravaillé le sujet depuis.
Ce que cette expérience montre — et ce qu'elle ne montre pas. Le protocole décrit (créer des contenus → les rendre disponibles sur le web → observer leur récupération, leur sélection puis leur citation) est un exemple assez parlant de tentative d'influence de la couche de récupération d'information (retrieval), telle que définie plus haut. Il ne permet en revanche pas de démontrer que le modèle de langage lui-même a été « entraîné » ou contaminé par ces publications : pour l'établir, il faudrait montrer que ces contenus ont intégré un corpus d'entraînement ou d'adaptation, ce que l'expérience ne teste pas.
Il faut aussi noter qu'un protocole de ce type ne contrôle généralement pas des variables qui pourraient expliquer une partie du résultat : évolution naturelle du corpus indexé, popularité des domaines utilisés, historique de ces domaines, fréquence de crawl, formulation exacte des requêtes testées, personnalisation de la réponse, ou absence de groupe témoin. L'agence en tire notamment la conclusion que « même sans backlinks ni forte autorité de domaine, la pertinence thématique du contenu suffirait à favoriser sa récupération et sa citation » : il s'agit là de son interprétation de sa propre expérimentation, pas d'un résultat établi indépendamment.
Un cas comparable, mais bien plus rigoureux, existe dans la recherche académique. En 2026, une équipe de Cornell Tech (Tingwei Zhang, Harold Triedman et Vitaly Shmatikov) a publié une étude démontrant qu'un ajout d'à peine 13 mots sur une seule page Reddit ou Wikipedia pouvait suffire à faire recommander une entité fictive par des agents de recherche approfondie (« deep research »), avec des taux de mention conditionnels d'environ 50 % sur les systèmes open source testés (STORM et Co-STORM). Les auteurs, qui nomment cette attaque WARP (Web Agent Retrieval Poisoning), ont analysé les taux de citation de contenu généré par les utilisateurs chez OpenAI Deep Research (0,4 % des citations) et Gemini Deep Research (12,1 %) sans toutefois y reproduire l'attaque en conditions réelles — une nuance importante qui distingue ce qui a été démontré de ce qui reste, à ce stade, une extrapolation plausible.
Cette étude confirme la même distinction que le cas de la pizza : agir sur ce que retiennent des agents de recherche est documenté et relativement accessible ; contaminer le modèle sous-jacent est une tout autre affaire.
Cinq couches d'influence : où peut-on agir sur une réponse d'IA ?
Le cas de la pizza et l'étude WARP invitent à sortir d'une opposition trop simple entre « le LLM-seeding fonctionne » et « le LLM-seeding ne fonctionne pas ». Une réponse générée par une IA de recherche traverse en réalité plusieurs couches successives, et chacune peut faire l'objet d'une tentative d'influence distincte :
| Couche | Question qu'elle pose | Illustrée par le cas pizza |
|---|---|---|
| 1. Découvrabilité | Le contenu existe-t-il et peut-il être trouvé sur le web ? | ✅ 120 contenus publiés |
| 2. Retrieval | Le système va-t-il le récupérer au moment de répondre ? | ✅ observé |
| 3. Sélection | Parmi les sources récupérées, lesquelles sont retenues ? | ✅ observé |
| 4. Citation / grounding | Quelle source sert à construire ou justifier la réponse ? | ✅ observé |
| 5. Entraînement | Ces données peuvent-elles ensuite entrer dans un futur corpus d'apprentissage ? | ❌ non démontré |
Cette grille a une conséquence directe pour le SEO et le GEO : il n'est pas nécessaire d'influencer le modèle lui-même pour influencer ce qu'il dit. Dans de nombreux cas observés, il suffit d'agir sur les quatre premières couches — découvrabilité, retrieval, sélection, citation — qui relèvent directement des leviers d'optimisation pour les moteurs génératifs, sans jamais toucher à la cinquième, beaucoup plus rare et beaucoup plus difficile à prouver.
Le partenariat Google-Reddit : quand les données deviennent une ressource stratégique
Le partenariat Google-Reddit illustre comment les données conversationnelles sont devenues une ressource stratégique dans le développement de l'IA générative. Ce type d'accord transforme les plateformes sociales en infrastructures d'apprentissage potentielles pour les LLM, avec des implications pour la confidentialité et pour les tentatives d'influence de l'information — sans que cela présume, comme vu plus haut, du rôle exact (entraînement, retrieval, ou simple surface d'influence) que joue une plateforme donnée à un instant donné.
Comment fonctionne concrètement la manipulation via le LLM-seeding
L'injection de contenu orienté
L'injection de contenu orienté suit généralement une méthodologie structurée : créer des comptes multiples sur Reddit et d'autres plateformes ciblées, puis publier massivement du contenu biaisé sur des sujets spécifiques, en veillant à ce que ces publications semblent naturelles et authentiques.
Les techniques d'injection les plus rapportées incluent :
- Création de discussions fictives mais crédibles
- Répétition de phrases et formulations spécifiques
- Utilisation de vocabulaire technique pour paraître légitime
- Manipulation des votes pour augmenter la visibilité
- Coordination entre plusieurs comptes pour simuler un consensus
Comme détaillé plus haut, cette approche vise le plus souvent la couche de retrieval — augmenter la probabilité qu'un contenu soit récupéré et cité — plutôt qu'une contamination du corpus d'entraînement lui-même.
Les techniques utilisées pour créer des réponses biaisées
La répétition massive constitue la méthode la plus directe : publier le même contenu sous différentes formes sur de nombreux fils de discussion pour augmenter la probabilité qu'un système le retienne comme source pertinente.
L'ancrage contextuel représente une technique plus sophistiquée : associer systématiquement certains mots-clés à des sentiments ou informations spécifiques. Mentionner systématiquement un produit avec des termes positifs dans des contextes variés peut ainsi favoriser des réponses plus favorables à son sujet.
La création de fausses références constitue une autre approche : citer des sources fictives ou déformer des informations réelles pour injecter de la désinformation qui pourra être reproduite comme si elle provenait de sources légitimes.
Exemples rapportés de tentatives de manipulation
Au-delà du cas de la pizza et de l'étude WARP détaillés plus haut — les deux exemples les mieux documentés à ce jour — plusieurs autres scénarios sont régulièrement évoqués sans toujours faire l'objet d'une documentation publique aussi solide : des entreprises qui publieraient massivement des avis positifs sur Reddit pour orienter les recommandations futures des assistants IA, des campagnes cherchant à biaiser des réponses sur des sujets politiques sensibles, ou des tentatives d'orienter des comparaisons de produits en dénigrant des concurrents. Ces scénarios sont plausibles au vu des mécanismes décrits plus haut, mais doivent être présentés comme des risques identifiés plutôt que comme des cas systématiquement prouvés et attribués.
Les acteurs et motivations derrière le LLM-seeding
Entreprises et organisations
Les entreprises représentent les acteurs les plus actifs dans les tentatives de LLM-seeding, avec pour motivation principale l'influence des recommandations générées par les LLM sur leurs produits ou services. Les stratégies rapportées incluent la publication de témoignages clients, la création de discussions techniques favorables à leurs solutions, ou la diffusion de contenu éducatif orienté — une évolution du marketing digital où l'optimisation pour les LLM (LLM SEO / GEO) devient un enjeu à part entière.
Agents malveillants et campagnes de désinformation
Des agents malveillants pourraient chercher à exploiter les mêmes mécanismes pour des campagnes de désinformation à plus grande échelle, sur des sujets politiques, sociaux ou scientifiques. Ce type de campagne présenterait un coût relativement faible comparé aux campagnes médiatiques traditionnelles, et une difficulté de détection et d'attribution plus élevée — mais reste, comme les exemples ci-dessus, davantage un risque documenté en théorie qu'une série de cas individuellement prouvés.
Le rôle des communautés Reddit
Les communautés Reddit jouent un rôle ambivalent : elles fournissent des données conversationnelles authentiques et diversifiées qui enrichissent les capacités des modèles, mais leur structure ouverte et leur modération variable les rendent vulnérables aux manipulations. Certaines communautés maintiennent des standards de qualité élevés ; d'autres, moins vigilantes, deviennent des vecteurs de contenu biaisé plus facilement.
Les risques et enjeux du LLM-seeding pour les utilisateurs
Confidentialité et sécurité des données personnelles
Les LLM peuvent involontairement révéler des données présentes dans leurs entrées ou leur contexte, un risque documenté dans le référentiel OWASP Top 10 LLM 2025 sous la catégorie LLM02 (divulgation d'informations sensibles) — à distinguer de la catégorie LLM04 (Data and Model Poisoning) qui couvre la contamination des données d'entraînement elle-même. Une tentative de LLM-seeding qui viserait spécifiquement à faire apparaître des informations personnelles dans les réponses d'un modèle aggraverait ce risque.
Biais culturels et manipulation de l'IA générative
Les LLM héritent des biais de leurs données d'entraînement, qu'il s'agisse de préjugés culturels, démographiques, linguistiques ou politiques. Une manipulation délibérée des données auxquelles un système est exposé peut renforcer ces biais ou en introduire de nouveaux.
| Type de biais | Description | Impact potentiel d'une manipulation |
|---|---|---|
| Culturel | Vision anglo-américaine dominante | Renforcement des stéréotypes culturels |
| Démographique | Sous-représentation de certains groupes | Marginalisation accrue |
| Linguistique | Favorisation de certaines langues | Déséquilibre linguistique aggravé |
| Politique | Orientation idéologique | Polarisation artificielle |
Le phénomène d'hallucination — un LLM générant des informations factuellement incorrectes avec assurance — se distingue de celui induit par une manipulation délibérée : dans le second cas, le contenu erroné a été spécifiquement conçu pour paraître cohérent et crédible, ce qui rend sa détection plus difficile. Les applications critiques (conseils médicaux, recommandations financières, assistance juridique) sont les plus exposées à cette confusion.
Impact sur la fiabilité des réponses
Les utilisateurs font de plus en plus confiance aux assistants virtuels pour obtenir des informations factuelles. Cette confiance devient un point de vulnérabilité lorsque les sources sous-jacentes — qu'il s'agisse du corpus d'entraînement ou des résultats de recherche — ont pu être influencées, en particulier pour le service client, les conseils médicaux, les recommandations financières ou l'assistance juridique.
Détection et prévention : comment identifier le LLM-seeding
Techniques de détection dans les corpus de texte
La détection s'appuie sur plusieurs approches complémentaires : l'analyse de fréquence (repérer la répétition anormale de certaines phrases ou relations sémantiques), l'analyse temporelle (identifier les pics soudains de contenu similaire sur une période courte, révélateurs de campagnes coordonnées), et le clustering sémantique (regrouper les contenus suspects pour révéler des réseaux de comptes coordonnés).
Le rôle du fine-tuning et de l'apprentissage par renforcement
Le fine-tuning sur des données vérifiées et de haute qualité permet d'atténuer l'influence de données manipulées présentes dans le pré-entraînement. L'apprentissage par renforcement à partir de retours humains (RLHF) introduit une couche de supervision qui peut corriger certains biais introduits par une manipulation, des annotateurs formés pouvant identifier et pénaliser les réponses reflétant des manipulations connues. Les techniques PEFT (Parameter-Efficient Fine-Tuning) comme LoRA permettent d'adapter rapidement un modèle sans réentraînement complet, offrant une réponse plus agile aux manipulations détectées.
👉 Comment les entreprises peuvent-elles protéger leurs systèmes de service client basés sur des LLM ?
En adoptant une défense en profondeur : privilégier des modèles entraînés sur des corpus diversifiés plutôt que dépendants d'une seule source ; mettre en place une validation humaine pour les réponses critiques ; utiliser des techniques comme le RAG (Retrieval-Augmented Generation) pour connecter le LLM à des bases de connaissances internes vérifiées, réduisant la dépendance aux données d'entraînement potentiellement compromises ; et établir un monitoring continu des réponses générées, avec des alertes automatisées sur les changements de comportement suspects.
Outils et ressources pour analyser les sources de données
Les plateformes open source comme Hugging Face proposent des bibliothèques pour examiner et nettoyer les corpus de texte avant leur utilisation dans l'entraînement (pandas, scikit-learn pour l'analyse statistique ; outils de visualisation pour repérer les patterns suspects ; corpus de référence vérifiés pour comparaison). Les centres de recherche et communautés académiques développent également des ressources partagées pour documenter les campagnes connues.
Les implications pour le développement et l'utilisation des LLM
Conséquences pour les développeurs et data scientists
La vérification de l'intégrité des données d'entraînement devient une étape critique qui nécessite des ressources considérables, transformant le développement de modèles en une tâche multidisciplinaire (sécurité, éthique, analyse forensique). Cette complexité accrue impacte les coûts et les délais de développement, et peut favoriser les acteurs disposant de ressources importantes.
Impact sur les applications d'entreprise
Les systèmes de service client automatisés basés sur des LLM risquent de fournir des informations biaisées ou incorrectes si leurs sources — d'entraînement ou de retrieval — ont été compromises, avec un risque direct sur la satisfaction client et la réputation de l'entreprise en cas d'incident rendu public.
Enjeux pour la création de contenu automatique
Les applications de génération automatique d'articles ou de code peuvent produire du contenu reflétant des biais présents dans leurs sources. La génération de code présente un risque particulier : un modèle exposé à du code peu sûr peut en reproduire les failles, d'où l'importance de systématiquement réviser et tester le code produit par les assistants IA, malgré les mécanismes de sécurité intégrés à des outils comme Claude Code.
Solutions et bonnes pratiques face au LLM-seeding
Diversification des sources de données d'entraînement
Plutôt que de dépendre massivement d'une plateforme comme Reddit, les développeurs de modèles ont intérêt à construire des corpus équilibrés incluant des sources variées et vérifiées : bases académiques et scientifiques, livres et publications éditoriales de qualité, sources multilingues. Cette approche réduit l'impact potentiel d'une manipulation ciblée sur une seule source.
Mise en place de systèmes de vérification et de validation
Ces systèmes s'intègrent à chaque étape du cycle de vie d'un LLM : filtres de qualité avant l'entraînement, métriques de surveillance pendant l'entraînement, puis monitoring continu après déploiement — comparaison avec des bases de connaissances de référence, détection d'incohérences factuelles, feedback des utilisateurs.
Le rôle de l'open source et de la transparence
Les modèles open source permettent à la communauté de chercheurs d'examiner les données d'entraînement et d'identifier les biais plus facilement que pour les modèles propriétaires. Documenter précisément les corpus utilisés pour l'entraînement devient un critère de qualité à part entière, permettant aux experts d'ajuster leur confiance en fonction des sources potentiellement compromises.
Cadre juridique et éthique du LLM-seeding
Responsabilité légale des manipulations
La responsabilité légale de ces pratiques reste un domaine juridique émergent. Selon les juridictions, une manipulation délibérée des données d'entraînement pourrait constituer une fraude, une manipulation de marché, une diffamation ou une violation des lois sur la protection des consommateurs — mais l'attribution et la preuve restent complexes, en particulier sur des plateformes anonymes.
👉 Existe-t-il des réglementations juridiques spécifiques contre le LLM-seeding ?
Le cadre juridique reste embryonnaire et fragmenté. L'AI Act européen établit des exigences de transparence et de qualité des données pour les systèmes d'IA à haut risque, ce qui pourrait inclure des obligations de détection et de prévention des manipulations. Aux États-Unis, aucune législation fédérale spécifique n'existe encore, bien que certaines lois sur la fraude ou la protection des consommateurs puissent s'appliquer selon le contexte. La difficulté principale réside dans l'attribution : prouver qu'une organisation a délibérément manipulé des données d'entraînement (par opposition à de simples tentatives d'influence du retrieval) nécessite des preuves techniques complexes et une expertise forensique avancée.
Réglementations émergentes
L'Union Européenne, avec l'AI Act, établit des exigences de transparence et de qualité des données pour les systèmes d'IA à haut risque, qui pourraient à terme imposer des obligations spécifiques de détection et de documentation des sources. Les États-Unis développent des standards fédéraux pour l'IA dans les applications gouvernementales, tandis que la Chine impose des réglementations strictes sur les algorithmes de recommandation, potentiellement extensibles aux LLM.
Principes éthiques pour un développement responsable
Trois principes structurent ce débat : la transparence sur les sources de données et les méthodes d'entraînement, l'équité via des équipes diversifiées et des audits réguliers par des parties indépendantes, et la responsabilité (accountability), avec des mécanismes clairs pour adresser les problèmes identifiés et en compenser les préjudices.
L'avenir des LLM face aux tentatives de manipulation
Évolution des architectures et techniques de protection
Les chercheurs explorent des approches comme l'apprentissage adversarial, où les modèles sont entraînés à résister aux tentatives de manipulation durant leur formation, ainsi que des techniques de détection d'anomalies en temps réel intégrées directement à l'architecture. Les architectures hybrides, combinant LLM et bases de connaissances structurées et vérifiées, offrent une autre voie : valider les réponses générées contre des sources de référence fiables avant de les présenter aux utilisateurs.
Le rôle de la communauté scientifique
Les centres de recherche développent des méthodes de détection avancées, établissent des benchmarks pour évaluer la robustesse des modèles et partagent leurs découvertes via des publications open source — à l'image de l'étude Cornell Tech citée plus haut. Cette collaboration internationale permet d'apprendre collectivement des nouvelles menaces.
Vers des modèles plus robustes et transparents
Les développeurs devront de plus en plus équilibrer performance, robustesse et explicabilité : traçabilité des sources pour chaque réponse, systèmes de confiance quantifiée, architectures modulaires permettant des mises à jour ciblées, mécanismes de vérification factuelle intégrés. Cette évolution nécessitera des investissements importants, mais devient indispensable pour maintenir la confiance du public.
Conclusion : plusieurs surfaces d'influence, pas un seul mécanisme
Le LLM-seeding, tel qu'on l'entend communément, ne désigne pas un phénomène unique mais une famille de tentatives d'influence qui interviennent à des niveaux très différents : la découvrabilité d'un contenu sur le web, sa récupération et sa sélection par un système de recherche, sa citation dans une réponse, et — beaucoup plus rarement et beaucoup plus difficilement — son intégration dans un futur corpus d'entraînement.
Le cas de l'expérimentation « pizza à l'ananas » et l'étude académique WARP de Cornell Tech convergent vers la même leçon : il n'est pas nécessaire d'influencer un modèle pour influencer ce qu'il dit. Il peut suffire, dans certains systèmes, d'influencer l'information qu'il récupère, sélectionne et cite — ce qui relève directement des leviers de découvrabilité, de sélection et de citation que le SEO et le GEO cherchent précisément à optimiser.
Cette distinction n'est pas qu'une nuance académique. Elle conditionne la réponse à apporter : diversifier les sources d'entraînement et documenter les corpus relève des développeurs de modèles ; surveiller et vérifier ce qui est récupéré et cité relève davantage des entreprises et des créateurs de contenu eux-mêmes. Les cadres juridiques et éthiques, encore embryonnaires, devront eux aussi apprendre à distinguer ces couches plutôt que de traiter la « manipulation des LLM » comme un phénomène monolithique.